Pipeline ETL
Pipeline ETL développé avec Talend pour intégrer, nettoyer et enrichir des données multi-sources.
Le projet
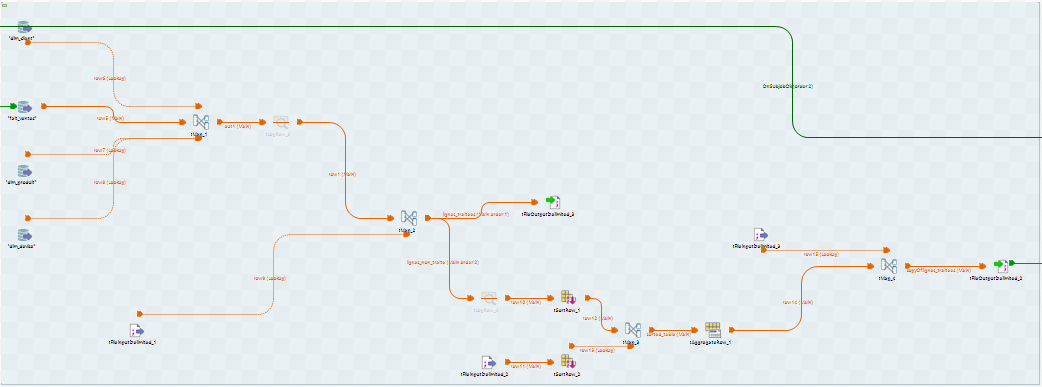
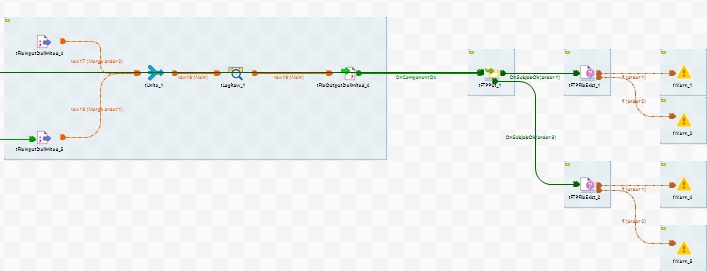
Ce projet consiste à construire un pipeline ETL avec Talend afin d'intégrer des données issues de fichiers CSV, d'une base MySQL et d'une API REST. Les traitements comprennent le contrôle de la qualité des données, l'harmonisation des formats, les jointures, les agrégations et l'enrichissement par des taux de change. L'objectif est de produire des données cohérentes et exploitables pour des analyses ultérieures.
Fonctionnalités principales
- Extraction et intégration de données depuis des fichiers CSV et MySQL.
- Contrôle des formats de dates et validation des données.
- Nettoyage, filtrage et déduplication des enregistrements.
- Jointures et transformations avec tMap.
- Agrégation des données avec Talend.
- Récupération de taux de change depuis une API REST.
- Enrichissement des données et export des résultats.
Architecture technique
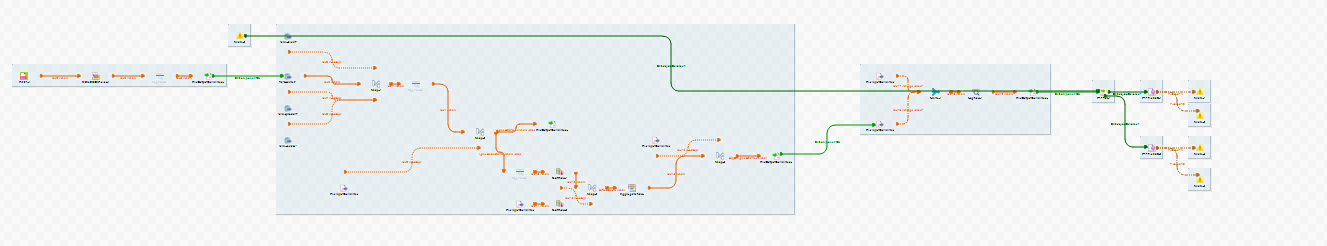
Des sources de données hétérogènes jusqu'à leur transformation et leur enrichissement dans un pipeline ETL.
Sources de données
Chargement des données issues de fichiers CSV, de MySQL et d'une API REST.
Nettoyage et validation
Vérification des formats, contrôle des dates, filtrage et gestion des doublons.
Transformation et enrichissement
Jointures, agrégations et intégration des taux de change à l'aide des composants Talend.
Export des données
Production de jeux de données nettoyés et transformés.
Choix techniques
Talend
Conception visuelle des flux ETL avec des composants dédiés à l'extraction et aux transformations.
SQL et MySQL
Exploitation de données relationnelles et intégration avec les flux Talend.
API REST
Récupération de taux de change pour enrichir les données avec des informations externes.
Stack technique
En pratique
Aperçu du fonctionnement de l'application et des résultats obtenus.